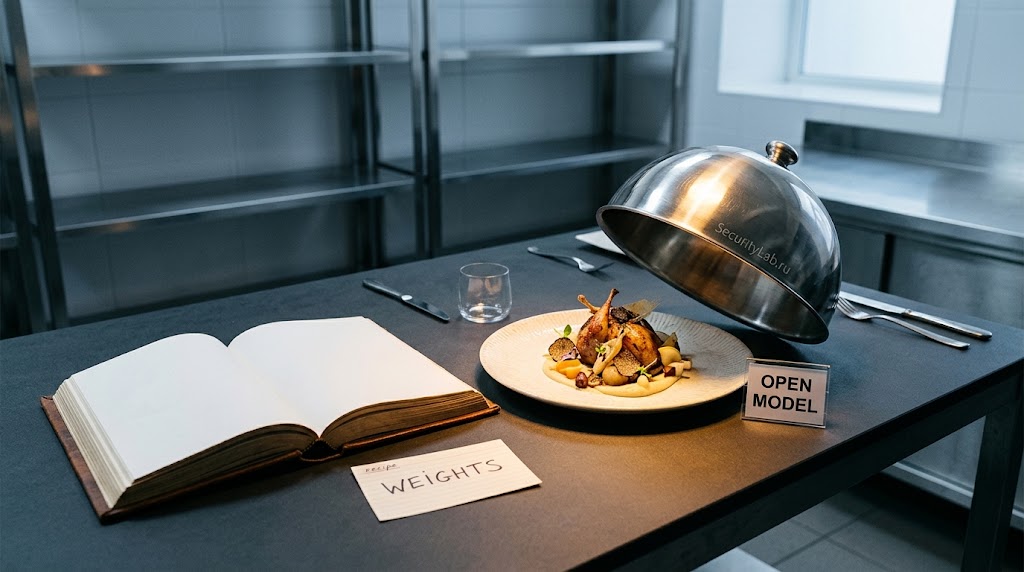
Скачать нейросеть, запустить на собственном сервере и даже дообучить под свои задачи ещё не значит получить open source. ИИ-компании всё активнее используют слово «open» для моделей с доступными весами, хотя разработчик по-прежнему может скрывать обучающие данные, код подготовки датасета и значительную часть процесса создания системы. Разница между открытыми весами и настоящим открытым исходным кодом превратилась из технического спора в вопрос доверия, лицензирования и регулирования.
Проблему подробно разобрали на фоне распространения так называемых open-weight моделей. Веса представляют собой числовые параметры нейросети, сформированные во время обучения. Вместе с архитектурой и кодом запуска параметры определяют, как модель обрабатывает запрос и формирует ответ. Публикация весов позволяет разработчику скачать модель, разместить внутри собственной инфраструктуры, дообучить на корпоративных данных и отказаться от внешнего API.
Для бизнеса подобная схема даёт вполне реальные преимущества. Запросы и внутренние документы можно не отправлять стороннему поставщику, компания получает больше контроля над расходами и меньше зависит от изменения тарифов или правил облачного сервиса. Однако открытые веса показывают лишь конечный результат обучения и почти ничего не говорят о пути, который привёл модель к финальному состоянию.
Без кода обучения и подробной информации о датасете независимый исследователь не может полноценно проверить происхождение данных, методы очистки и фильтрации, представленность языков и отдельных групп, возможное попадание тестовых наборов в обучение или влияние последующей настройки безопасности. Становится значительно сложнее воспроизвести создание модели и понять причины конкретного поведения. Директор Stanford Institute for Human-Centered AI Джеймс Ландэй считает открытые веса важным шагом, но отделяет возможность запустить готовую нейросеть от возможности проверить и воспроизвести процесс разработки.
Open Source Initiative пытается провести более чёткую границу. Принятая в октябре 2024 года OSAID 1.0 называет ключевыми четыре свободы: использовать систему без дополнительного разрешения, изучать устройство, изменять под любые задачи и распространять исходную или модифицированную версию. Для машинного обучения одного файла с весами недостаточно. Разработчику также потребуется открыть необходимый код и предоставить достаточно подробную информацию об обучающих данных, чтобы специалист мог создать существенно эквивалентную систему.
Полной публикации каждого исходного файла OSAID при любом сценарии не требует. Часть обучающих данных может подпадать под авторские права, договорные ограничения или другие запреты на распространение. В подобных случаях подробное описание происхождения, состава, отбора и обработки датасета должно дать исследователям возможность понять процесс обучения. Именно граница между достаточным описанием и настоящей воспроизводимостью остаётся одним из главных предметов спора вокруг определения OSI.
Единого мнения нет даже внутри сообщества свободного ПО. Критики OSAID считают определение слишком мягким и указывают, что без исходных обучающих материалов термин open source теряет привычный смысл. Параллельно Linux Foundation развивает лицензию OpenMDW 1.1 , предназначенную специально для моделей машинного обучения. Лицензия охватывает архитектуру, параметры, данные, документацию и программный код, которые разработчик решил предоставить, и задаёт единые условия использования таких материалов.
OpenMDW тоже не решает проблему полной открытости автоматически. Лицензия не заставляет владельца модели публиковать все данные, код или инструменты обучения. OpenMDW регулирует права на уже опубликованные компоненты. В августе 2026 года Linux Foundation передала OpenMDW 1.1 на рассмотрение OSI для возможного официального одобрения. Среди участников разработки лицензии указаны представители Amazon, Meta, IBM, Microsoft и Nvidia.
Терминологический спор уже вышел за пределы разработчиков. В мае министры цифровых технологий стран G7 приняли общие принципы описания открытости ИИ. Документ предлагает рассматривать открытость как спектр и отдельно учитывать ограничения на использование, доступность весов, код запуска, код обучения и тренировочные данные. Авторы также рекомендуют не называть модель просто «открытой», если более точное обозначение лучше отражает реально опубликованные компоненты.
Для разработчиков разница имеет практическое значение. Доступные для скачивания веса отвечают прежде всего на вопрос, можно ли самостоятельно запустить готовую модель. Настоящий open source требует намного большего: возможности изучить происхождение системы, изменить фундаментальные компоненты, проверить процесс обучения и свободно построить собственную работу поверх опубликованных материалов. Пока индустрия использует одно слово «open» для принципиально разных уровней доступа, ярлык остаётся значительно проще самой технологии.